Statistique inférentielle, échantillonnage, R Studio
|
Contexte: on souhaite expérimenter l'échantillonnage sur un jeu de données contenant les dépenses de
l'état en 2017 et voir si on retombe sur les mêmes valeurs, par exemple si on peut retrouver la moyenne
globale à partir d'un échantillon, le but est de découvrir le concept , voir quand ça marche, quand ça ne marche
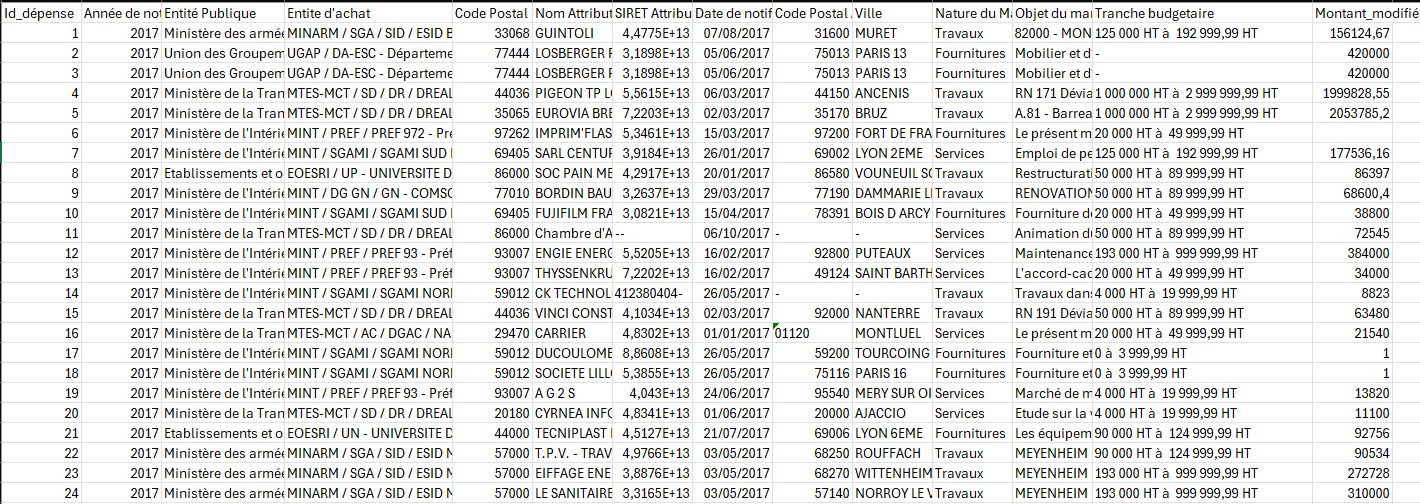
pas et pourquoi. On souhaite obtenir une liste de plusieurs intervalles de confiance, pour après comparer avec les valeurs réelles. Données : on dispose d'un fichier de l'Insee contenant les dépenses de l'état sur l'année 2017, avec comme modalité le code postal, l'organisme le montant , etc pour chaque dépense. Vous pouvez voir un extrait du tableau ci-dessous . |
|
|
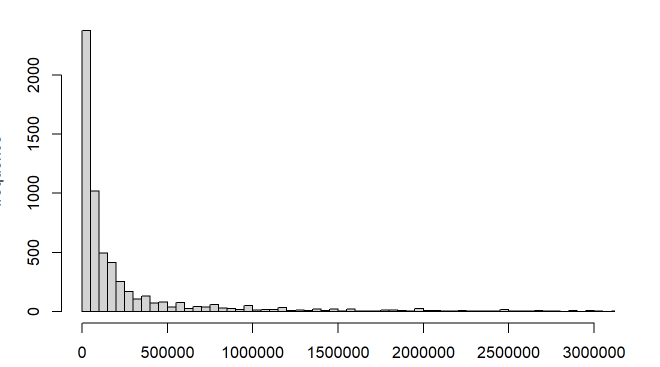
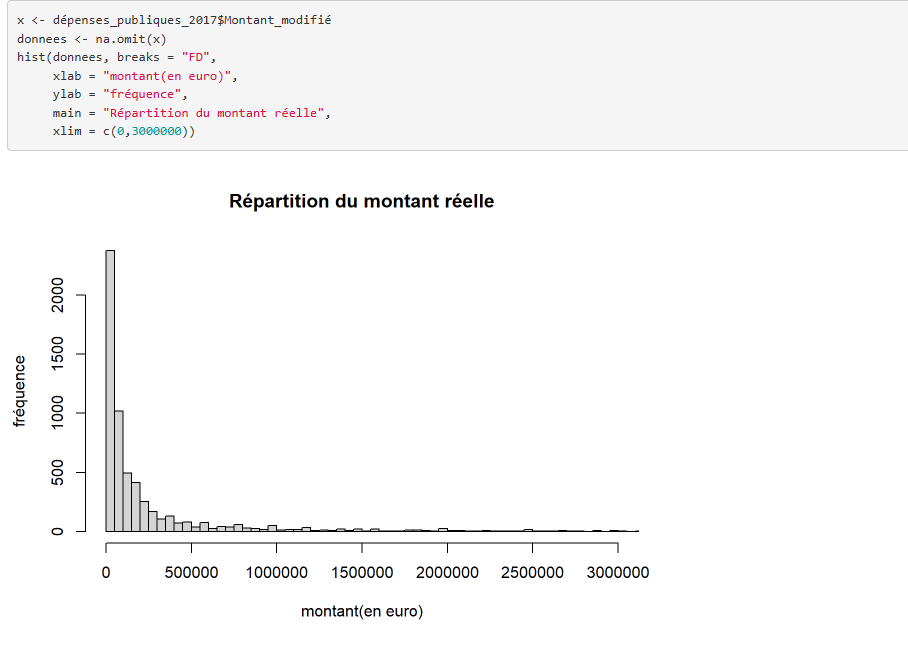
| On fait une première visualisation des données pour voir la répartition des dépenses. On utilise na.omit afin de ne pas prendre en compte les valeurs inconnues, et one pose une limite à 30 000 000 avec xlim car on avait quelques valeurs au dessus qui emêchaient totalement de faire ressortir quoi que ce soir du graphique tellement la dispersion était élevée : on avait un écart-type qui valait 37 051 554. |
|
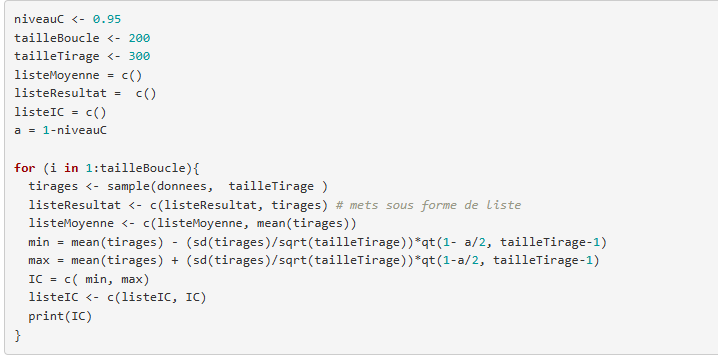
On souhaite créer des échantillons à l'aide d'une boucle. On commence par définir les paramètres
souhiatés comme l'intervalle de confiance , la taille de chaque tirage ou encore le nombre de fois que la
boucle se répétera. La boucle créé les intervalles de confiance pour chaque échantillon. |
|
|
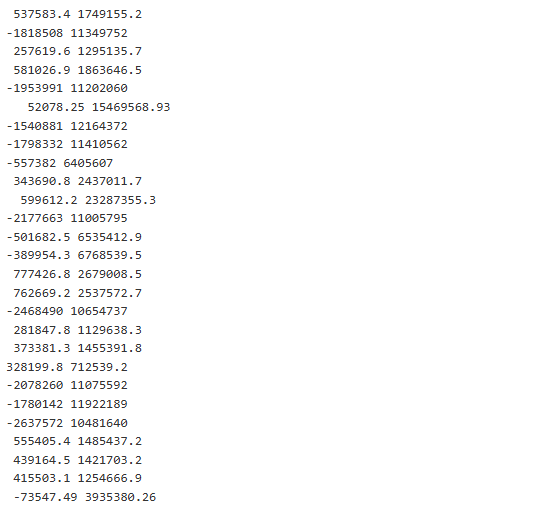
L'échantillon a une longueur de 60 000 valeurs , un écart type de 34 198 825 et la moyenne est de
2 342 428. On rapelle la formule de l'intervalle de confiance avec a = 1- niveau de confiance et qtt étant le coefficient venant de la table de student que l'on trouve à partir de l'effectif et du niveau de confiance. IC (Intervalle de confiance) =[moyenne - (écart type/ racine(n))qtt(1- a/2, n-1) ; moyenne + (écart type/ racine(n))qtt(1- a/2, n-1)] On remarque qu'on a des valeurs négatifs pour le minimum dans l'intervalle ce confiance, cela s'éxplique par un écart type trop élevé, qui était souvent bien plus grand que la moyenne ce qui rendait le minimum négatif. |
|
|
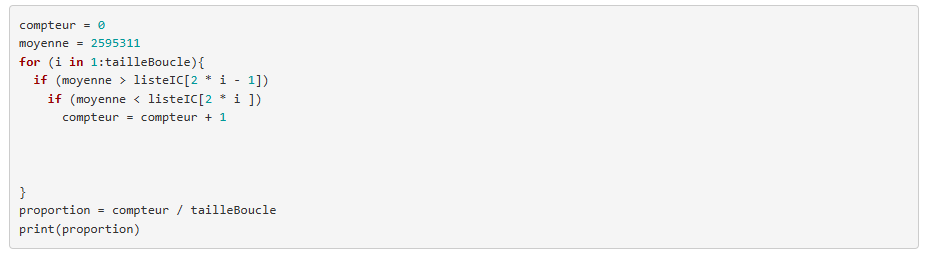
On souhaite obtenir la proportion de l'échantillon étudié pour lesquels la moyenne de la population totale
est comprise dans l'intervalle de confiance. La moyenne de la population totale vaut 2 595 311. Pour chaque intervalle de confiance, on commence par regarder si la moyenne est supérieur au minimum puis, si elle est infèrieure au maximum. Quand les deux conditions sont remplies on ajoute 1 au compteur. On divise le compteur pour la taille de la boucle puis on obtient la proportion d'échantillons valides. On trouve 51,5% de proportion valide ce qui est assez faible. A chaque fois qu'on a lancé ce code, on trouvait des valeurs autour de 50%. |
| Dû à une dispersion des valeurs qui était bien trop élevée, il n'a pas été possible d'atteindre les niveaux de confiance souhaités. |